VoxAI
给你自己的 AI 装上耳朵和嗓子的会议副驾:本地实时转写、分得清谁在说话,AI 把建议推进会议窗口,也能出声对话。
官网直发版在售。Mac App Store 和 iOS App Store 均已上架。
转写工具在会后给你一份文档。可你需要帮助的时刻是在会中。
不做转写工具了。把用户自己的 AI 请进会议室:它通过本机的服务实时听会,用卡片或者声音回应。
一个名字下发了三款产品:macOS 会议副驾,从立项到公开在售三个半月;Mac App Store 版,从立项到上架八天;还有 iPhone 版。现在都在售或在架。
- 3
- 款产品,同一个名字下
- 8 天
- 从立项到 Mac App Store 上架
- 3 天
- 搭完整条收款和授权链路
- 3–5×
- 一小时会议的 token 降到三到五分之一
- 0.12%
- 会中分人的 CPU 占用
正在发售的应用的真实界面,对话内容是演示数据:先是 iPhone 版,再是 Mac 版。iPhone 版界面是中文的,转写支持中文和英文。
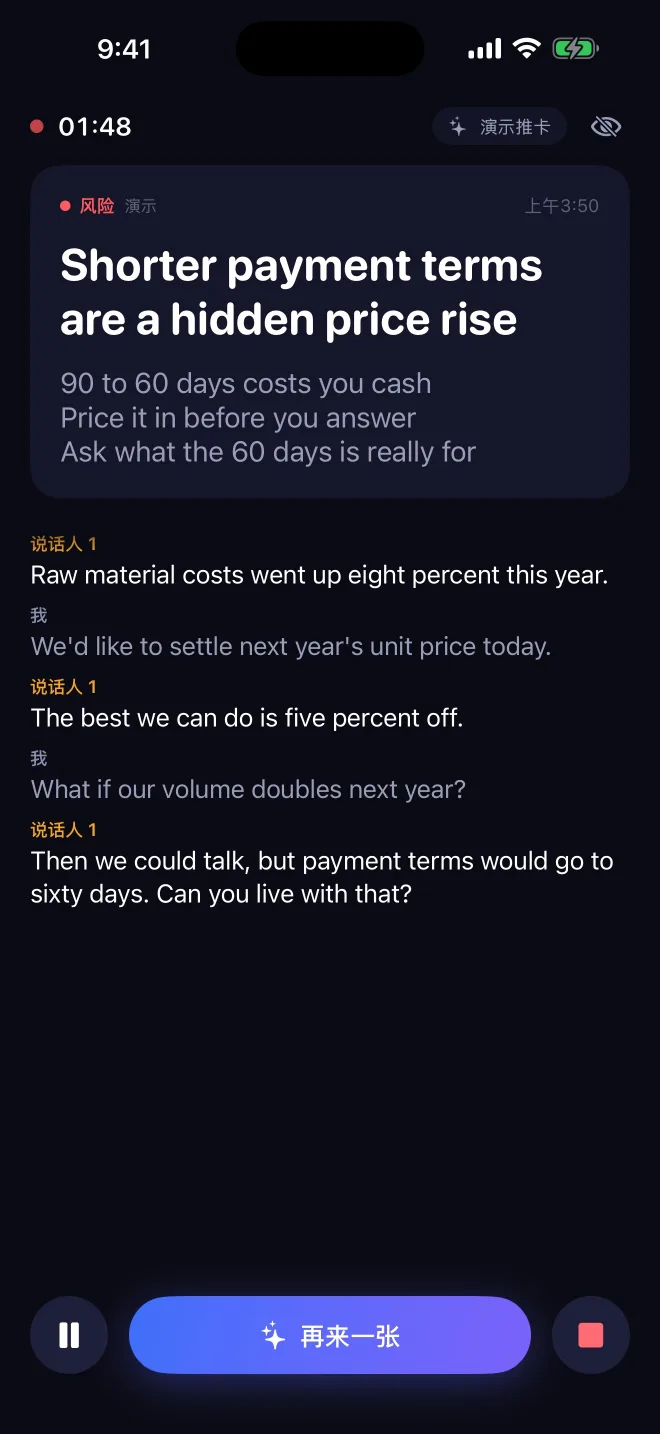
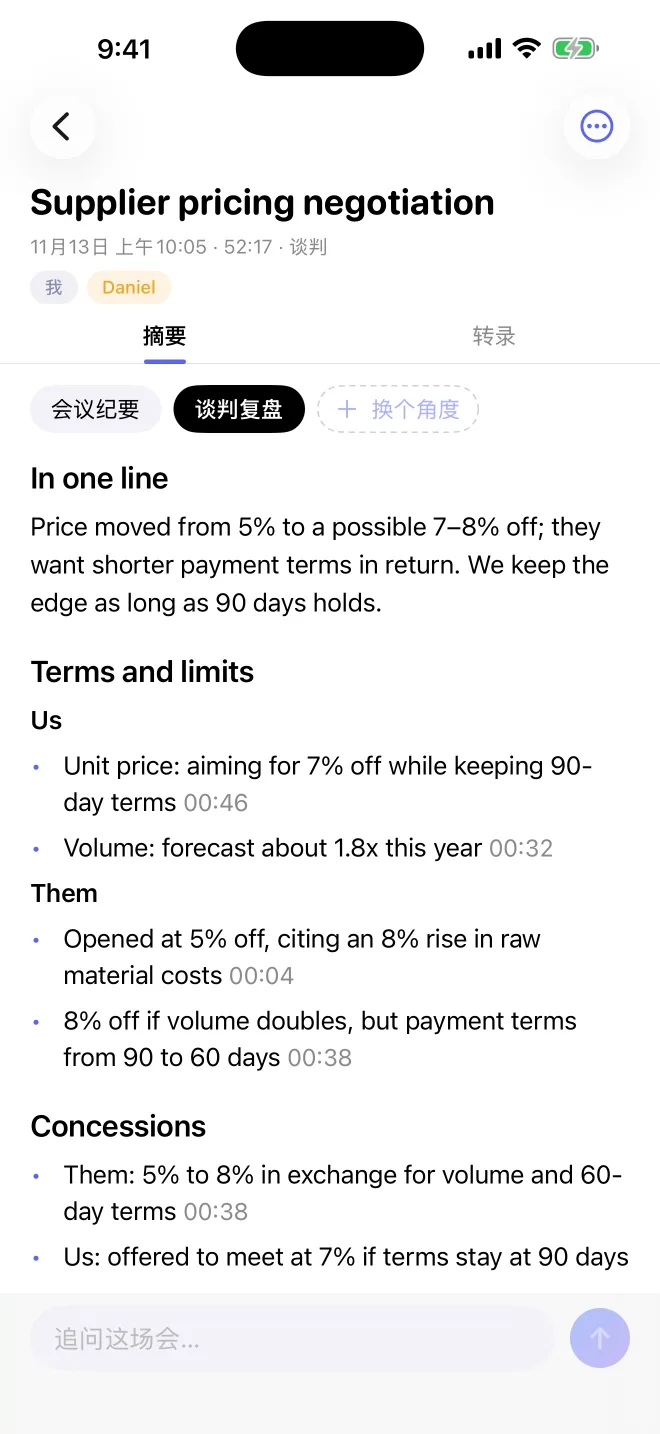
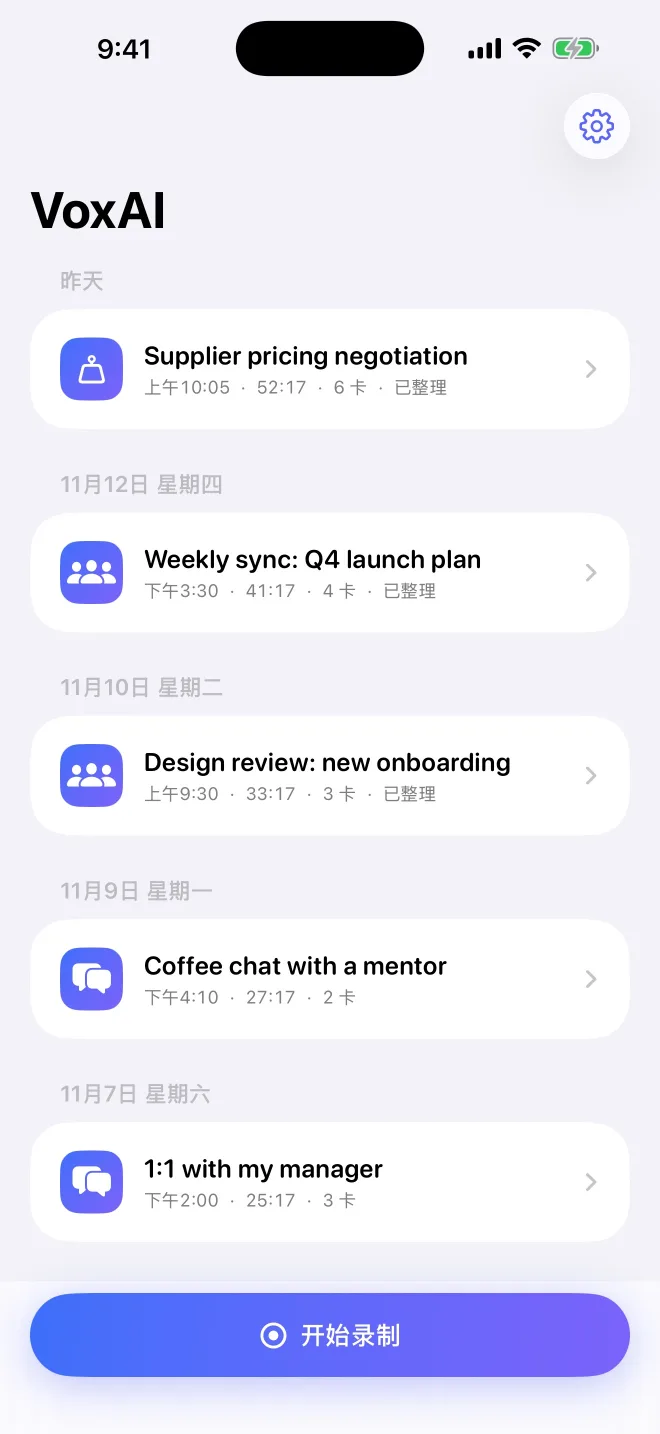
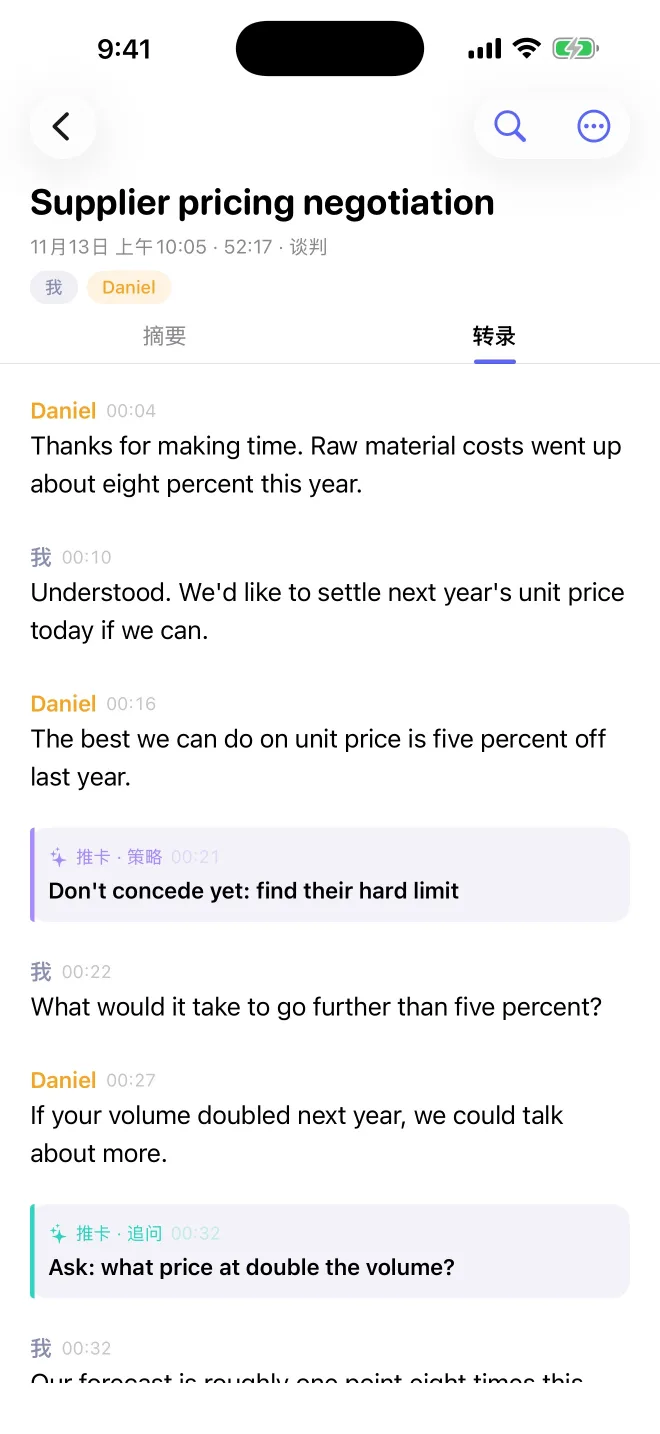
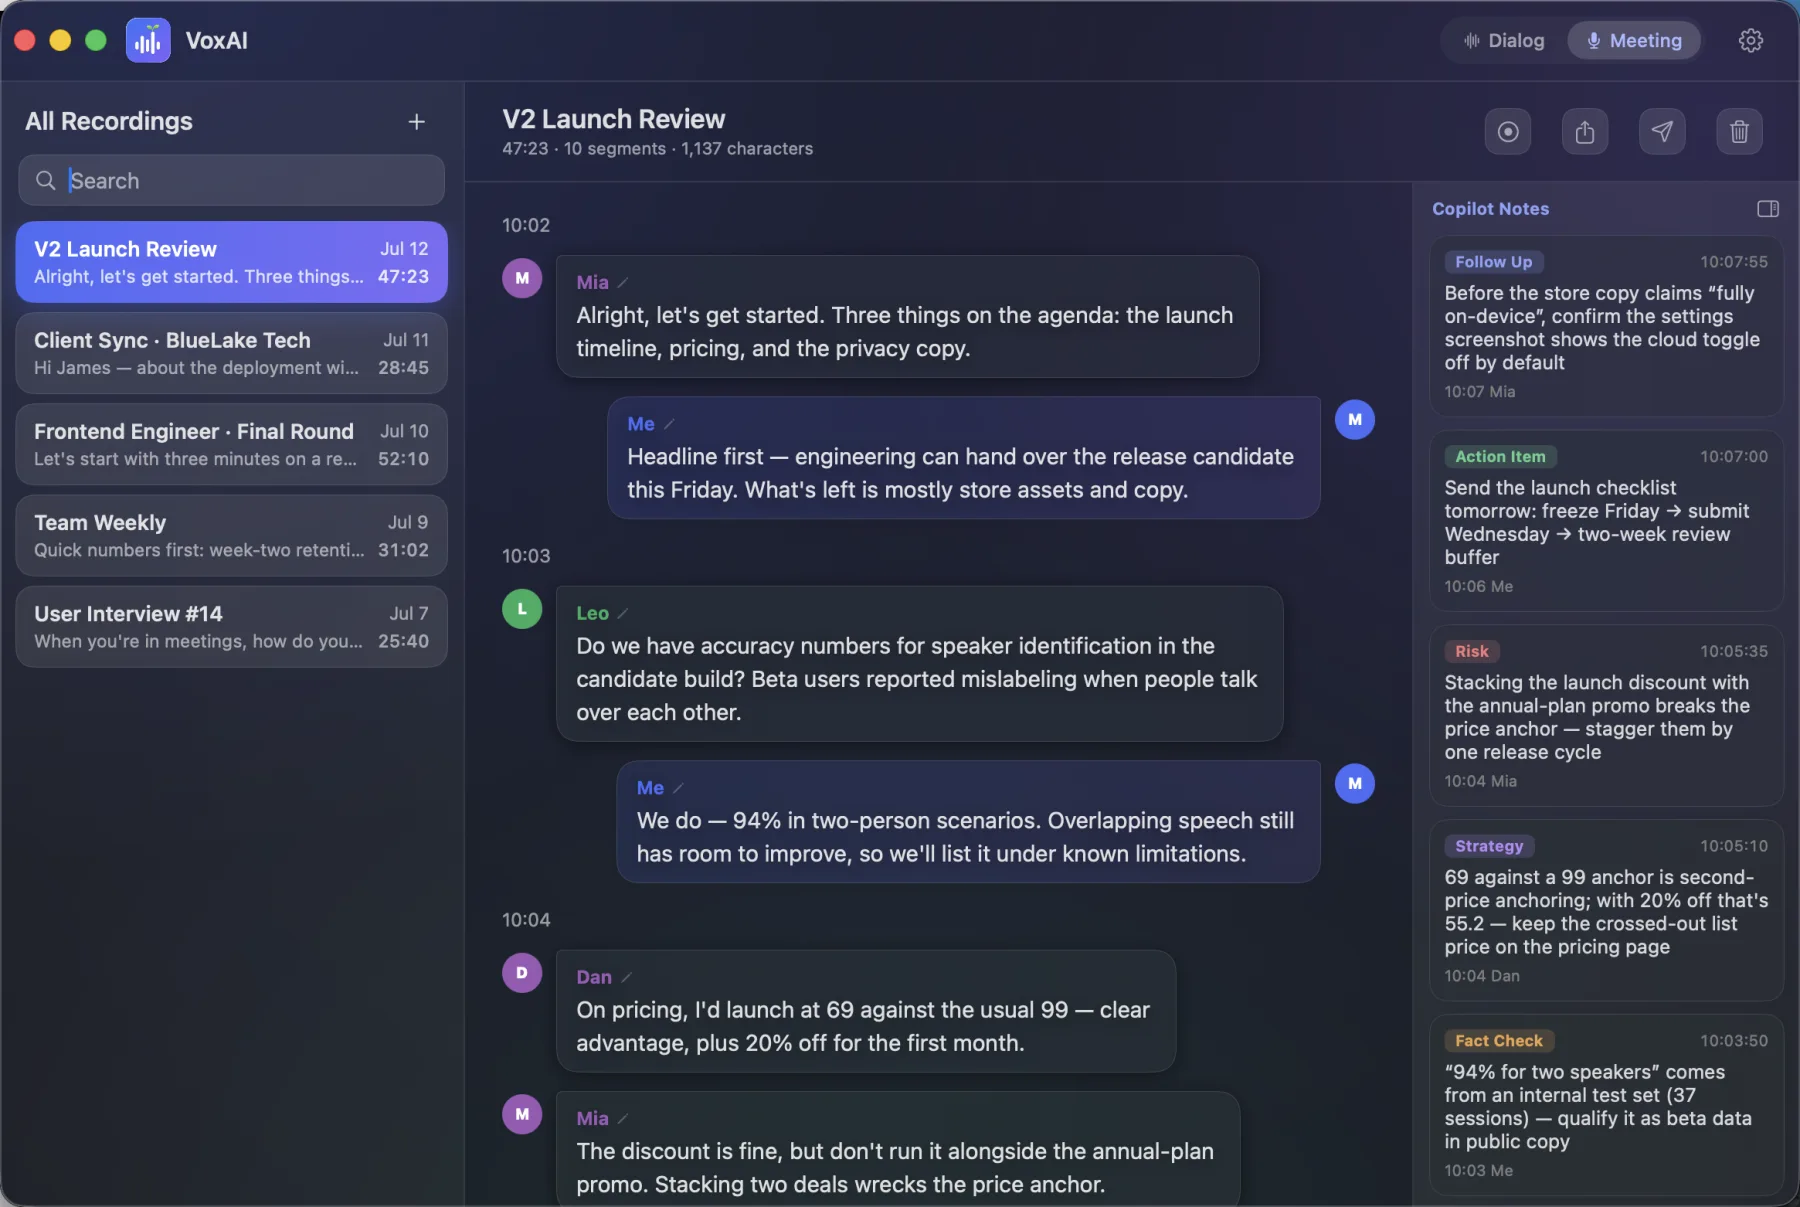
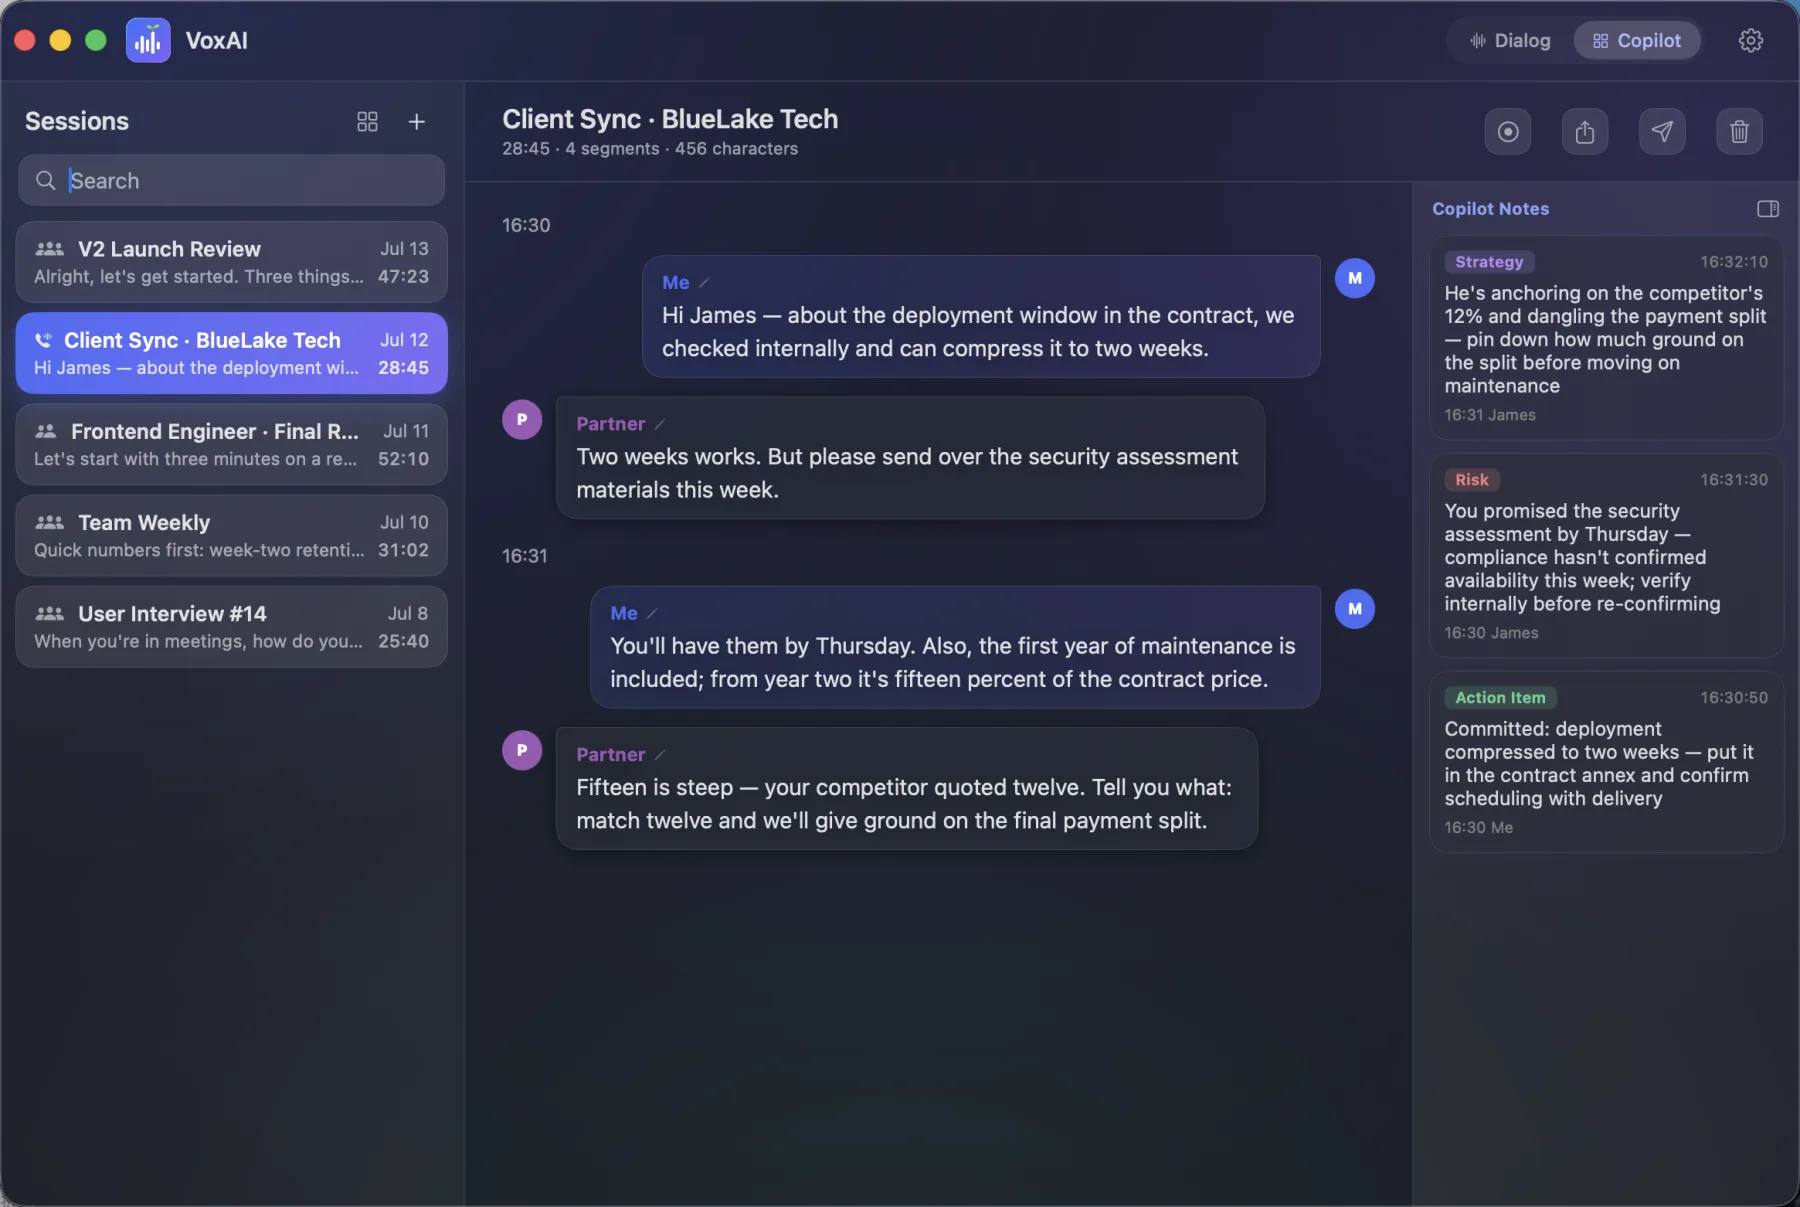
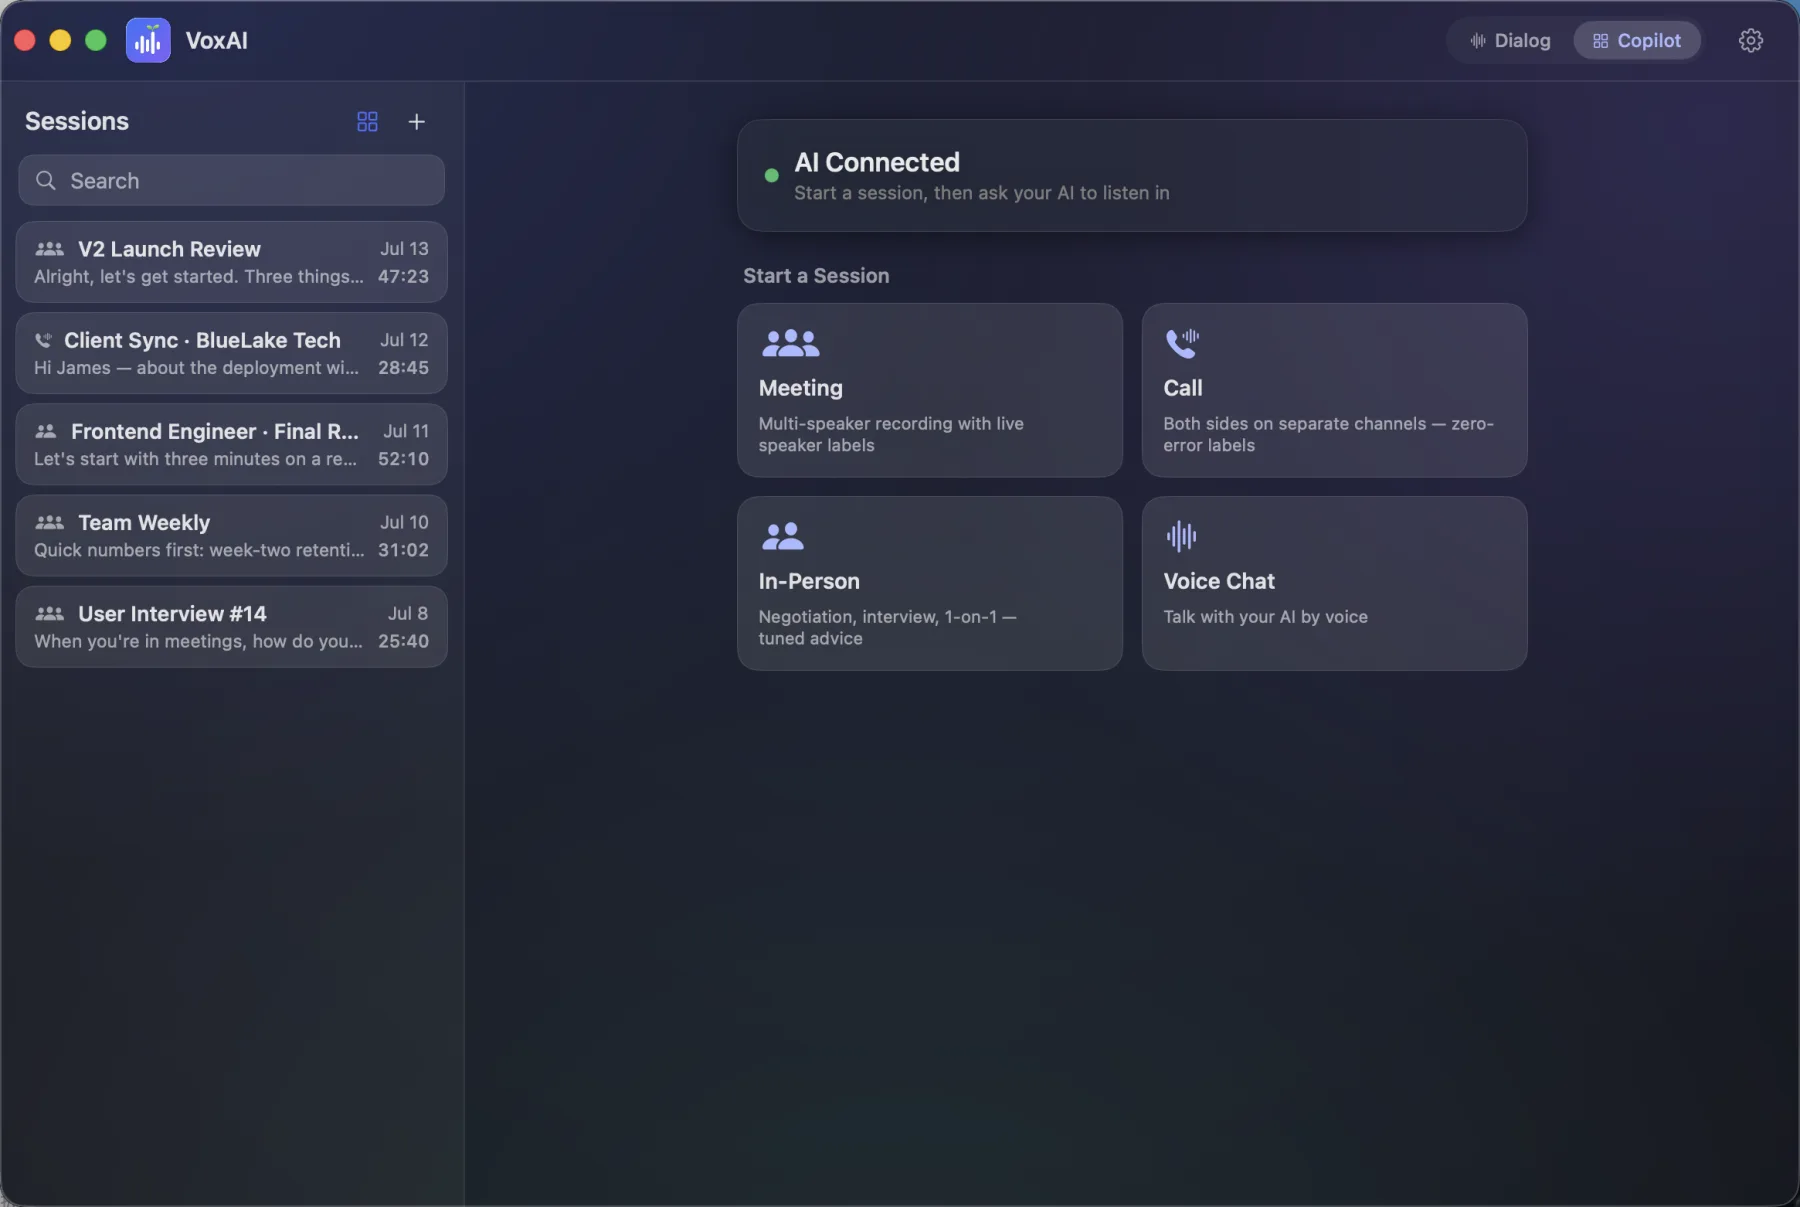
从工具变成在场
它一开始是个转写工具。做了三个月,我把问题从「他们说了什么」换成「谁和我一起在场」。转向 11 天后,一个 AI 全程旁听了一场 25 分钟的多人会议。
不比现在差,才替换
换模型只有一条规矩。换精修模型时,我用三场真实会议跑了四种引擎。没有人工标注的标准答案,就两两比字错率,再加上肉眼读。这样才发现一种引擎会幻觉出重复的句子,另一种整段喂进去会无限复读,必须先按停顿切段。
把代价摆上桌再拍板
把会中分人挪到神经引擎上,CPU 占用降到 0.12%。对照会后整场离线分人的结果,一致率掉了约 8 个点。为了续航和发热我接受这笔交换,并加了兜底:超过四个人说话时自动整场重分,测试会议上的一致率回到 86.9%。
证据变了就推翻自己
商店版第一次发布时,我把它砍到只做听写。十周后我推翻了这个决定,把完整的副驾移植进了沙盒版。
量的是试用,不是下载
我把用户旅程拆成五段漏斗,在试用模式上连着做了三轮实验,把「试用完成率」定成产品唯一的北极星指标。
让用户的 AI 自己完成接入
把 AI 接到本机服务上,是用户最容易放弃的一步。我把引导反过来:用户让自己的 AI 去接,配置由 AI 来做。
一个约束,逼出三套架构
沙盒里的商店应用,不能自带一个允许外部进程拉起的辅助程序——而用户的 AI 客户端正是外部进程。于是:直发版走公证,保留 Python 的模型引擎;商店版是沙盒里的纯 Swift;AI 连的那个服务用 Swift 重写,在商店外分发,通过应用容器里的文件交换数据。
不用声纹模型也能分人
通话的时候,麦克风是我,系统声音是对方。把两路分开录,分人里最难的那部分就不存在了。面对面的会议用跑在神经引擎上的本地分离。
给 AI 设计的接口
公开的接入服务里有 17 个工具,不开网络端口:应用和 AI 之间靠原子写入的文件交换数据。一个阻塞式的等待在有新语音后约半秒内返回,AI 自己不用轮询。重新设计这个等待返回的内容后,一小时会议的开销从 50–80 万 token 降到约 15 万。
全部在本机跑
直发版里,转写、分人、语音合成都在 Apple 芯片上本地运行。会议内容不出这台电脑。
三天搭完收款链路
公证直发、应用内自动更新、Ed25519 签名的离线激活、Stripe 接 Cloudflare Worker。从付款到拿到激活码只要几秒,全程不用人工。
不报错的公证失败
时间戳服务时断时续,导致 89 个内嵌库没签上,而打包脚本报的是成功。现在改成逐个文件签名加重试,发版前逐个校验每一个内嵌的二进制。
发热
一个让电脑发烫的会议应用会被直接退掉。主线程 CPU 从 30.6% 降到 9.6%。
全部:产品、macOS 和 iOS 应用、本地模型管线、MCP 服务、公证、授权与收款、两个商店的提审。
- Swift
- SwiftUI
- ScreenCaptureKit
- AVAudioEngine
- Core ML · Neural Engine
- Python
- MCP
- StoreKit
- Stripe
- Cloudflare Workers
- Ed25519 licensing
- Developer ID notarization